试验设计、变量控制与统计判定
试验设计的目标不是制造一张漂亮曲线,而是用最少且风险可控的运行区分竞争解释,并估计结论的不确定性。
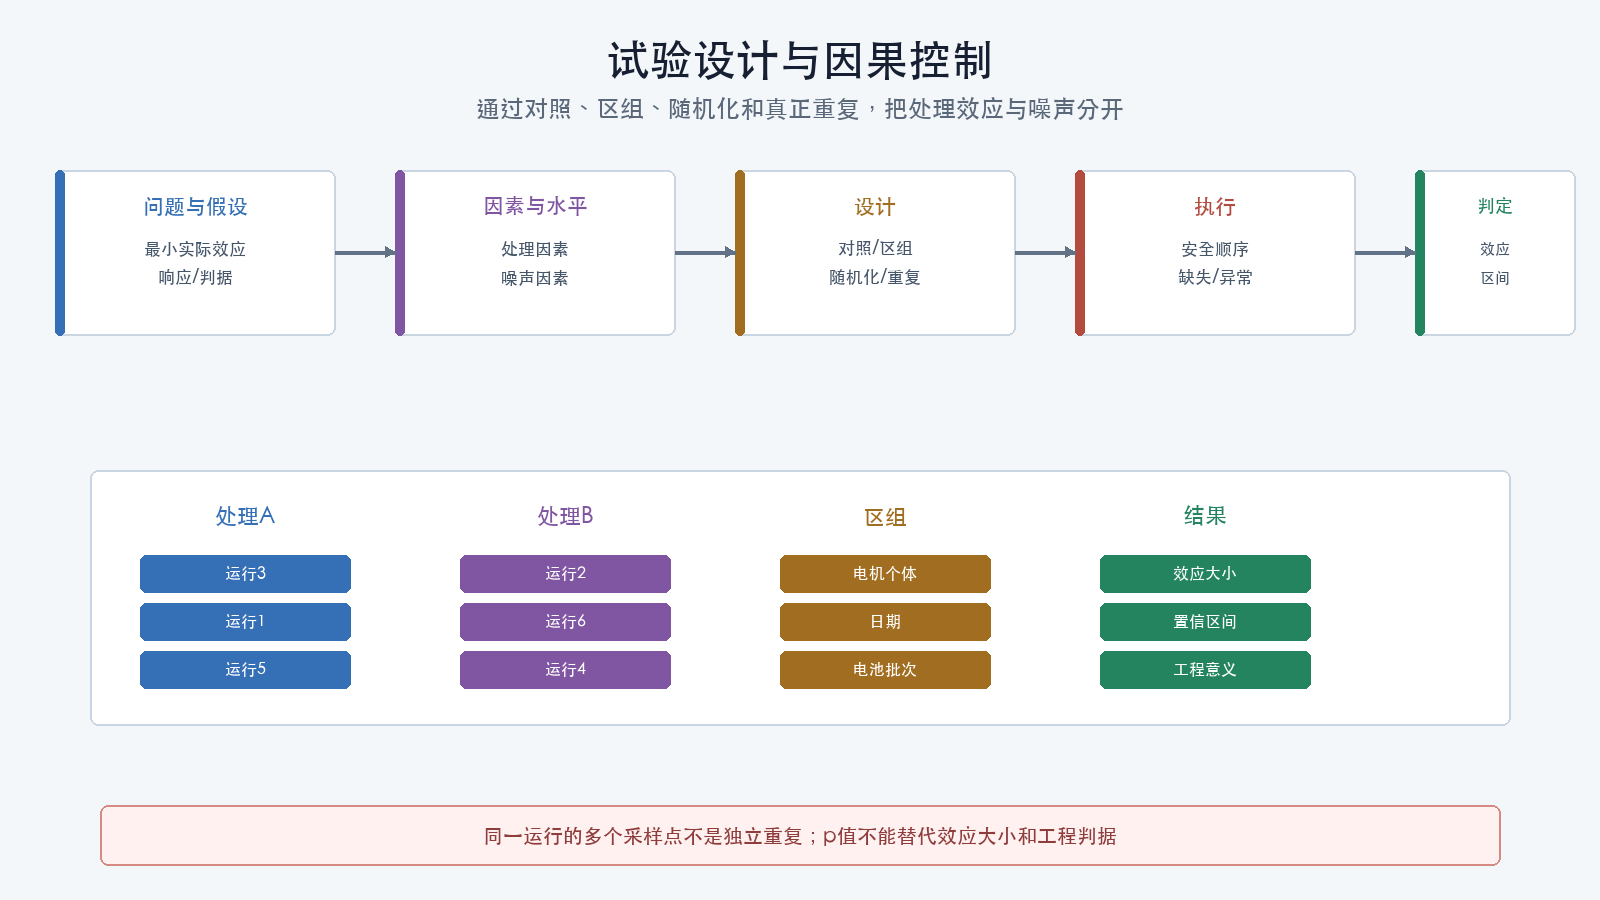
从问题到假设
先判断问题类型,不是每个测试都需要原假设显著性检验:
| 问题类型 | 核心输出 | 典型方法 |
|---|---|---|
| 描述与估计 | 值、变异和置信区间 | 描述统计、区间估计 |
| 符合性判定 | 是否满足预设工程限值 | 测量不确定度、保护带 |
| 比较 | 候选间效应大小 | 对照设计、区间或检验 |
| 等效/非劣 | 是否落在预设等效界值内 | 等效区间或专门检验 |
| 可靠性/寿命 | 失效概率、寿命或下限 | 寿命模型、删失数据方法 |
| 探索 | 发现趋势和后续假设 | 图形、筛选设计、独立确认 |
统计显著性不能替代工程通过判据。符合性试验通常直接针对批准限值,不需要为了得到p<0.05另造原假设。
需要统计推断时再写:
- 问题;
- 原假设与备择假设;
- 需要检测的最小实际效应;
- 响应变量;
- 控制因素;
- 噪声因素;
- 混杂因素;
- 实验单元;
- 判据和决策。
例如“新螺旋桨更高效”至少要定义:
- 在什么推力、转速、电压和环境下;
- 效率是克每瓦、牛顿每瓦还是任务能耗;
- 多大差异才值得更换;
- 测试的是一副桨还是设计总体;
- 如何处理电池电压、温度和电机差异。
因素、水平和响应
| 对象 | 示例 |
|---|---|
| 因素 | 螺旋桨型号、电压、控制设置 |
| 水平 | 型号A/B、四串/六串、低/中/高工作点 |
| 响应 | 推力、功率、温升、振动 |
| 噪声因素 | 环境温度、电池状态、操作者 |
| 实验单元 | 一次独立装夹后的动力组合运行 |
同一日志里的多个采样点通常属于一个实验单元,不能当成独立重复。
一次一因素的限制
一次一因素(OFAT,One Factor At a Time)便于初步排查,但难以发现交互作用。例如滤波设置在低转速和高转速下可能产生不同效果。
析因设计可以同时估计:
- 主效应;
- 因素交互;
- 曲率;
- 噪声和区组影响。
高风险实物试验不应为了统计完整性无条件执行所有组合。先在模型、SITL或低能量台架筛选,再把必要组合带入高风险环境。
随机化
随机化用于降低运行顺序与未知变化混杂的风险。例如按A-A-A-B-B-B执行时,电池衰减可能被误认为型号差异。
随机化前仍要满足:
- 每个顺序在安全上允许;
- 设备能够恢复到一致初始状态;
- 暖机和冷却条件明确;
- 切换不会引入残留效应。
若安全要求必须按低载荷到高载荷递增,不能强行完全随机;应记录限制,使用区组、交叉日次或独立样件降低偏差。
区组
对已知且难以消除的变化源使用区组:
- 电池批次;
- 测试日期;
- 操作者;
- 电机个体;
- 环境温度区间;
- 场地;
- 固件构建。
在同一区组内比较候选,避免把日次或样件差异混入处理效应。
对照
对照可能是:
- 当前批准配置;
- 未施加处理的空白;
- 已知可检测异常的阳性对照;
- 已知正常的参考件;
- 中心点运行;
- 零输入或假负载。
不同对照作用不同。没有当前批准基线时,“候选更好”可能只是在两个未知状态中选择一个。
重复与伪重复
真正重复需要独立重新建立实验条件。以下通常不构成独立重复:
- 同一运行的多个采样点;
- 同一文件的重复处理;
- 同一装夹连续读取;
- 多个算法窗口覆盖相同原始数据;
- 多个电机通道共享同一电池和环境却被当作完全独立。
技术重复可以估计测量短期波动,但不能代替独立样件和独立运行。
样本量
样本量应在执行前依据:
- 最小有实际意义的效应;
- 变异估计;
- 显著性水平(\alpha);
- 检验功效(1-\beta);
- 单侧或双侧;
- 设计结构;
- 允许的丢失和无效运行;
- 安全与资源约束。
不能按“至少三次”作为所有试验通用规则。样本过少可能无法区分等效和证据不足;样本过多又可能把没有工程意义的微小差异判成统计显著。
置信区间优先
报告:
- 效应估计;
- 置信区间;
- 单位;
- 样本量;
- 设计;
- 模型假设;
- 原始分布;
- 缺失和异常。
只报告(p)值会隐藏效应大小和不确定性。
p<\alpha表示在模型与原假设成立时数据足够极端,支持拒绝原假设。它不表示原假设为假的概率,也不表示效应有实际价值。
p\ge\alpha只表示未能拒绝,不能证明“完全相同”。等效需要预先定义等效界值并使用相应区间或检验。
单侧和双侧
只关心“是否更高”时也不能随意使用单侧检验。必须在看数据前说明:
- 反方向差异是否没有安全意义;
- 为什么只需一个方向;
- 判据与风险是否允许。
安全指标常常两个方向都重要,例如响应过慢和过快都可能有风险。
多重比较
对多个候选、指标和时间窗反复使用未校正的(\alpha=0.05),会增加至少一次假阳性的概率。
可按设计使用:
- 预先指定少量对比;
- Bonferroni或其他族错误率控制;
- Tukey/Tukey-Kramer全配对;
- 假发现率控制;
- 同时置信区间。
全局方差分析显著只说明至少一组不同,不说明每一对都不同。
异常值
处理顺序:
- 标记,不立即删除;
- 检查原始记录、仪器、配置和操作;
- 判断是否为数据错误、真实极端或未知;
- 按预先规则处理;
- 同时报告包含与不包含该点的敏感性分析;
- 保存原值和处置理由。
异常值检验通常有分布假设。连续反复删除“最异常点”会放大错误率,并可能删除真实故障证据。
缺失数据
记录缺失原因:
- 仪器丢样;
- 测试中止;
- 样件故障;
- 文件损坏;
- 人工漏记;
- 判据触发后停止。
由故障导致的缺失通常不是随机缺失。只分析成功完成的运行会产生幸存者偏差。
一个受控动力比较示例
目标:比较候选A和当前基线B在三个预先批准工作点的输入功率。
设计:
- 以电机个体和测试日期为区组;
- 每次运行重新安装并检查;
- 在区组内随机A/B顺序;
- 电池使用受控电源或记录电压状态;
- 工作点顺序按安全要求从低到高;
- 每个工作点达到稳定条件后取预定义窗口;
- 推力、转速、电压、电流和温度同步记录;
- 超温、振动或工装位移立即停止;
- 分析主效应、工作点交互和置信区间。
若A只在高工作点改善,而温升和振动越界,不能只报告平均效率更高。
预注册测试卡
问题类型:估计/符合性/比较/等效/可靠性/探索
问题与需求ID:
原假设/备择假设:适用时填写
最小实际效应:
响应及单位:
因素与水平:
实验单元:
区组:
随机化:
重复:
样本量依据:
统计模型:
异常和缺失处理:
多重比较处理:
工程通过判据:
不通过判据:
无效判据:
停止条件:
检查理解
- 为什么同一日志中的千个采样点不等于千次试验?
- 区组与随机化分别解决什么问题?
p≥0.05能否证明两个方案等效?- 为什么异常值不能只按数值大小删除?
- 安全递增加载与随机顺序冲突时如何处理?